|
|
从零到LLM:从基础原理到大型语言模型的机器学习之路 英语 1322页 可以AI翻译阅读
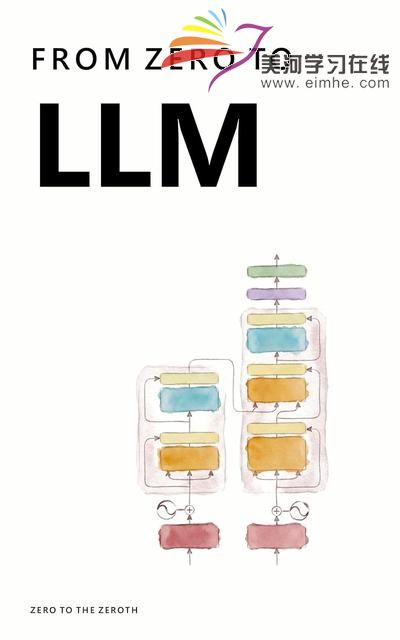
如果询问聊天机器人是如何工作的,通常会得到两种答案。一种说法是“它能够预测下一个单词”,这一说法虽然正确,但却没有解释其预测准确度的来源。另一种答案则是用一整页的公式来说明。本书则采取了介于两者之间的解释方式。
一切始于一家咖啡馆试图预测第二天的冰拿铁销售情况,随后,通过逐步完善各种理念,最终形成了ChatGPT、Claude和Gemini背后的模型。每一步的出现都是因为前一步遇到了瓶颈:之所以需要“注意力机制”,是因为单个向量无法承载整句话的信息;之所以需要“变换器架构”,是因为逐个处理字符会导致GPU资源浪费;而“RLHF技术”的出现,则是因为单纯的文本预测工具并不足以充当助手的角色。在学习过程中,你将使用PyTorch来训练和调试小型网络,自行实现注意力机制以及简单的GPT模型,同时还会学会估算模型的内存占用情况并计算相关成本。
后半部分介绍了工作中会用到的相关技术:GPU与大规模训练、对齐与推理模型、LoRA与QLoRA、量化与推理过程、长上下文处理、多模态模型、智能体,以及如何判断某个测试结果是否有实际意义。本书面向那些每天都在使用这些模型,但却没有亲自开发过它们的软件工程师、数据分析师和技术产品经理。只需具备基本的Python编程能力以及高中水平的代数知识即可。在需要时,会教授衍生函数、矩阵、概率论以及PyTorch相关知识。
“从零开始”系列中的每一本书都是为那些没有相关背景的读者而写的:首先会通过直觉和类比来讲解概念,只有在必要时才会涉及数学知识和细节,这样,整个领域就会变成一条可以由读者自行探索的道路。
|
|
 |小黑屋|手机版|Archiver|美河学习在线
( 浙网备33020302000026号 )


 发表于

 在线QQ客服2
 添加客服QQ
