|
|
NVIDIA GPU 基础架构详解:从 CUDA 到生产运维的系统化指南 英文版 共236页
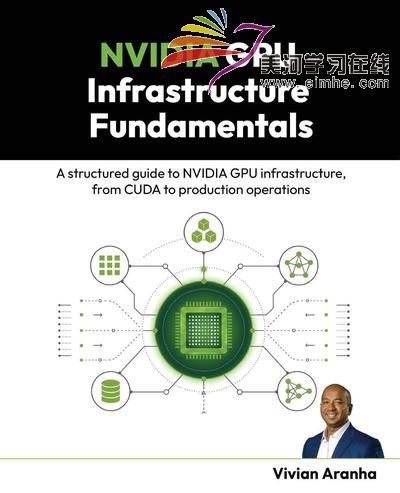
通过一份系统化的指南全面了解NVIDIA GPU生态系统。对比各项技术,理解不同平台层之间的交互方式,从而能够更明智地评估各种基础设施方案及其优缺点。
主要特点
●了解GPU、CUDA、网络、存储以及DPU是如何为人工智能任务提供支持的
●了解MIG、vGPU、DCGM、Kubernetes、Slurm、NGC和Triton的用途。
●在人工智能的开发与部署全生命周期中,实现各类基础设施组件的互联互通。
NVIDIA的GPU基础设施涵盖了硬件、系统软件、网络、存储、调度机制、机器学习运营以及推理功能等方面。要理解这些组件之间的关联、各自的职责范围,以及哪些差异是重要的,就需要有一个清晰且结构化的分析思路。
本书通过连贯的叙述,为人们指明了了解NVIDIA GPU基础设施架构的路径。它首先介绍了加速计算技术、CUDA以及NVIDIA的软件生态系统,随后还对比了数据中心中的GPU与不同工作负载的特性。书中还探讨了用于资源共享与监控的MIG、vGPU和DCGM技术;用于GPU调度的Kubernetes和Slurm技术;以及网络与存储相关的技术,包括以太网、InfiniBand、RDMA、GPUDirect Storage、BlueField DPUs和DOCA等。
后续章节将通过Airflow、MLflow和Kubeflow来实现基础设施与AI生命周期之间的关联,进而实现MLOps流程;通过NGC来处理软件交付工作;而通过ONNX、TensorRT和Triton来实现模型推理功能。此外,您还将了解支撑生产环境中的GPU集群运行的各种Kubernetes组件、监控技术、扩展策略以及诊断方法。
通过将这些技术相互关联起来,而非将它们视为独立的产物,本书能够帮助你比较不同的平台选择、了解各组件的功能边界、分析各种权衡因素,从而建立起关于NVIDIA GPU基础设施的清晰认知模型。
你将学到的内容
●区分人工智能、机器学习与深度学习
●解释为什么GPU能够加速现代人工智能任务的处理速度
●根据训练和推理需求选择合适的NVIDIA GPU
●在常见的资源共享场景中,可选择MIG或vGPU。
●比较以太网与InfiniBand在分布式人工智能任务中的应用表现
●将MLOps工具与人工智能生命周期中的相应阶段相对应。
●对比ONNX、TensorRT与Triton在推理流程中的差异
●追踪跨平台层的GPU集群问题 |
|
 |小黑屋|手机版|Archiver|美河学习在线
( 浙网备33020302000026号 )


 发表于

 在线QQ客服2
 添加客服QQ
